- 启动时间:2025 年 7 月初
- 持续周期:基础内容 12 周
大连理工大学人工智能入门计划负责人
大连理工大学人工智能入门计划
计划时间
学习计划
以下是项目的最新动态和重要更新:
注意:在每周学习的时候可以同时关注前沿方向,找到适合自己的研究方向,具体可参考学习资源中的每周必做
- 零基础:按部就班完成每一周任务,逐渐找到学习方向与技巧
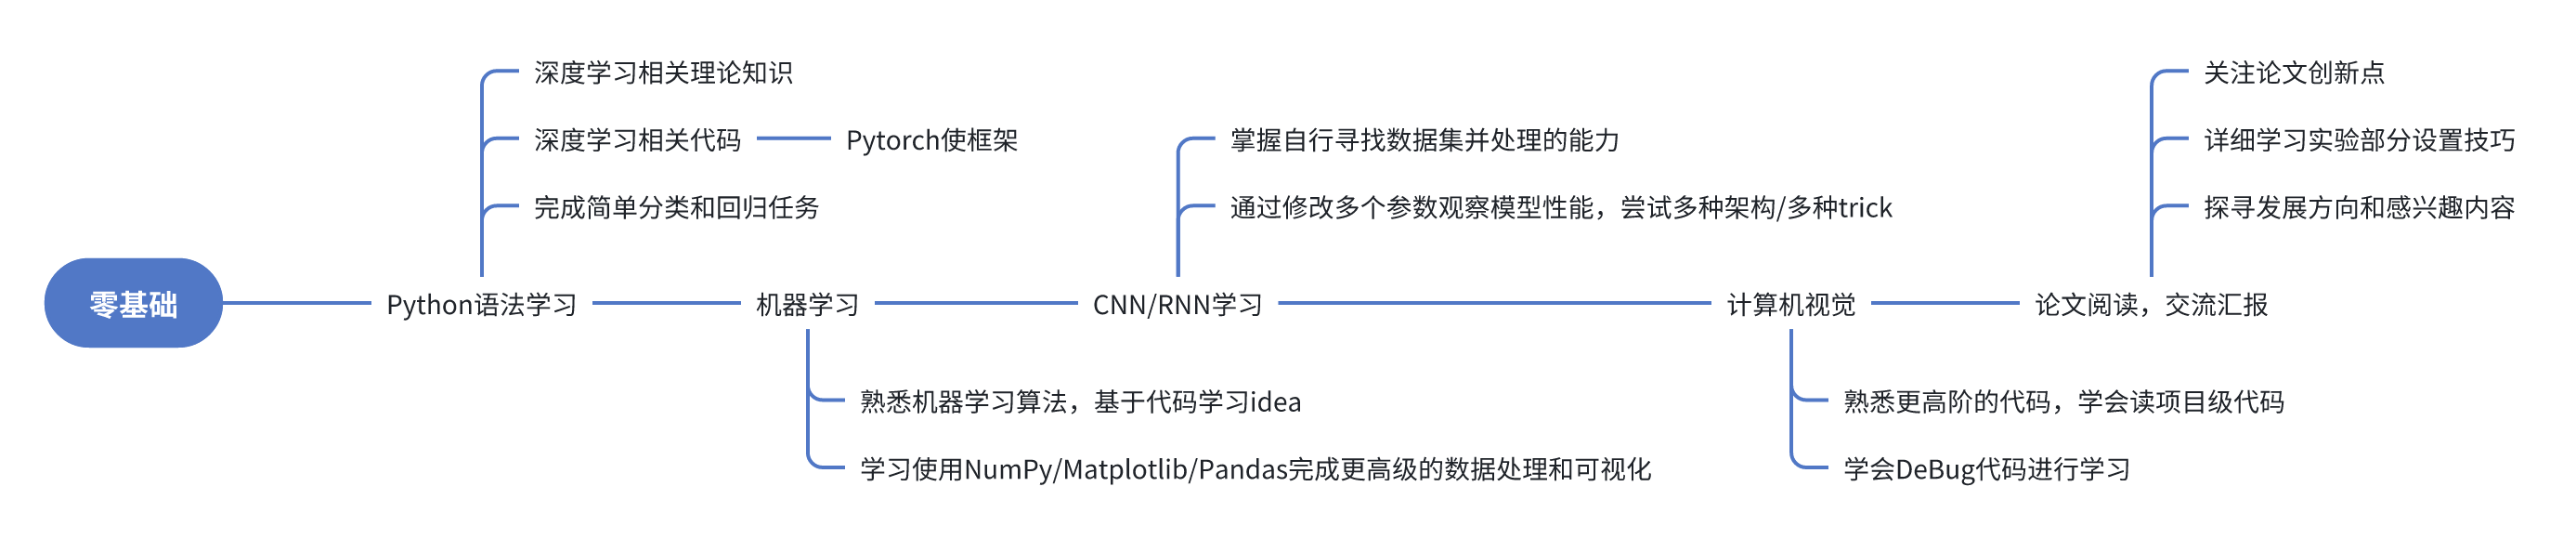
- 入门者
跳过基础语法,直接进入 CNN/RNN + 论文复现,强调调参与实验设计
.png)
- 进阶者
复习前五周内容后直接进入第六周,聚焦经典论文 + 最新方向(如 LLM、多模态),鼓励提出改进点
课程资源总览
课程资源分为:
电子教材
视频课程
(带有 Jupyter Notebook 之类可直接上手的代码)
GidHub教学仓库
(带有 Jupyter Notebook 之类可直接上手的代码)
线上线下组会分享汇报
(如何读论文、做实验、分析研究领域、投稿以及参与同学的日常汇报分享)
公众号资源(即使追踪最新技术)
组内教师历史资源总结
推荐教材(电子书)
《深度学习》
剑桥大学出版社教材,在线免费版,系统介绍深度学习基础。适合有一定数学基础的学习者。
链接:在线阅读
链接:在线阅读
《神经网络与深度学习》
免费在线书籍,通俗讲解神经网络核心概念和深度学习技术。适合入门和深入理解。
链接:在线阅读
链接:在线阅读
《统计学习导论》
经典统计学习教材,非技术性地介绍回归、分类、重抽样、正则化、无监督学习等主题。适合统计背景较弱的初学者。
链接:官方网站(含 PDF 下载)
链接:官方网站(含 PDF 下载)
《深度学习必备数学》
讲解机器学习所需的线性代数、概率统计等数学基础(Imperial College 开设同名课程)。适合需要回顾数学的学员。
链接:在线阅读
链接:在线阅读
🎬 机器学习视频课程
• 吴恩达《机器学习》系列(Machine Learning)英文授课,中英字幕 —— 斯坦福经典公开课,系统介绍机器学习基础知识和理论概念,适合初学者,帮助构建学习基本概念,总时长17小时。
Machine Learning
高清翻译优化版
进入课程学习,获取更多知识?
00:01 / 00:45
A
斯坦福大学 Andrew Ng 教授
Andrew Ng / 吴恩达
• 李宏毅《机器学习》课程(中文授课)—— 台湾大学教授讲解,深入浅出,通过实例讲解机器学习和深度学习的原理,注重理解学习,实时性较强,总时长17小时。
00:01 / 48:20
李
台湾大学 李宏毅教授
李宏毅 / Hung-yi Lee
• 李宏毅教授机器学习课程,内容涵盖机器学习基础知识、深度学习、神经网络等主题,讲解深入浅出,适合初学者入门。
• 课程特点:理论与实践相结合,通过大量实例帮助理解复杂概念,实时性强,包含最新研究进展。
• 学习建议:配合课程讲义和作业,结合实际项目进行练习,加深理解。
• 课程特点:理论与实践相结合,通过大量实例帮助理解复杂概念,实时性强,包含最新研究进展。
• 学习建议:配合课程讲义和作业,结合实际项目进行练习,加深理解。
- MIT 6.S191 深度学习入门(英文) —— 麻省理工 6.S191
课程,从基础线性模型到神经网络、递归网络等,最新版课程视频更新至 2025 年。链接:MIT Intro to Deep Learning (YouTube)
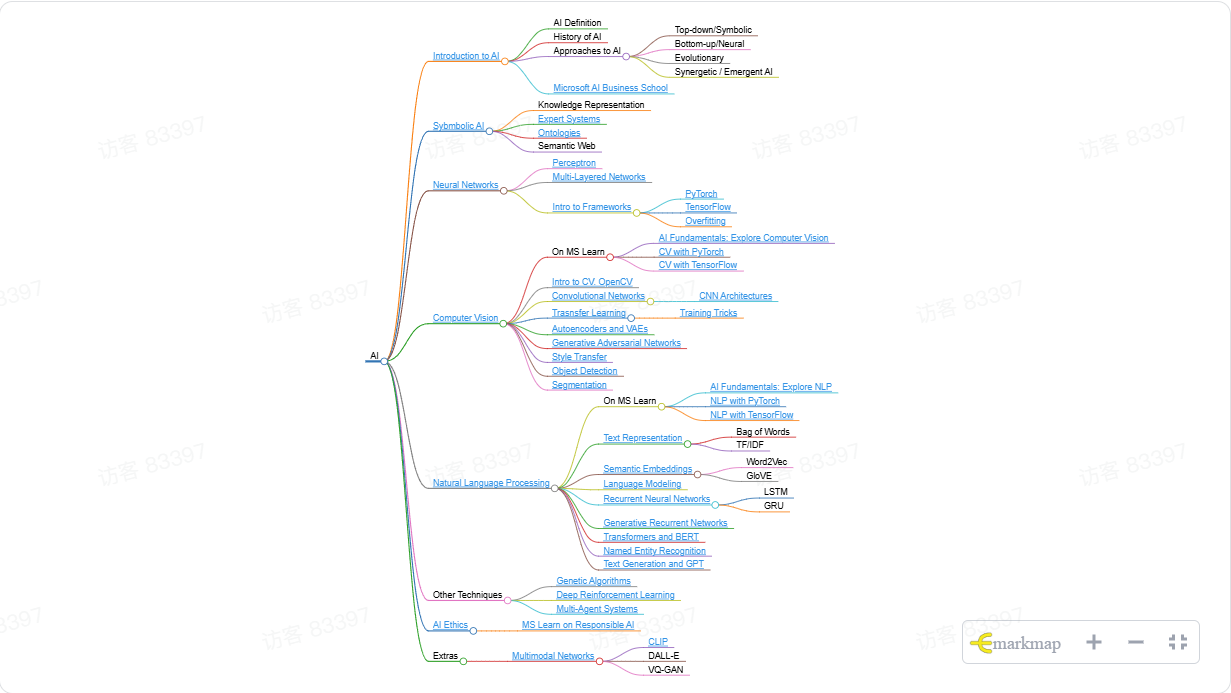
- 微软《AI for Beginners》课程(英文) —— 微软推出的 12 周 AI 入门课程(免费,课程资料开源于
GitHub),内容涵盖符号 AI、神经网络、计算机视觉、自然语言处理等,使用 TensorFlow 和 PyTorch 框架。链接:GitHub 资源
- EZ.Encoder Academy —— 实时性最好,最前沿的论文系统解读,尤其是 Deepseek 系列的阐释
- python 快速入门
张
▶
点击播放视频
▶
00:00 / 14:26
GitHub 教学仓库
• 《动手学深度学习》(Dive into Deep Learning, Aston Zhang 等著,中英双语) — 开源交互式教材,包含文本、数学和代码,以 Jupyter 笔记本形式教学,覆盖 PyTorch/TensorFlow 框架,适合初中级读者。链接:
组会分享记录 【同学制作的 PPT 都会在此共享】
顶会投稿的经验总结和建议(初学者)
 点击图片跳转到详情页面
公众号资源

PaperEveryday
公众号简介
量子位
公众号简介
极市平台
公众号简介
中国图象图形学会
公众号简介
CVer
公众号简介
机器学习
公众号简介
更多学习资源
AI
AI洞察
人工智能前沿资讯与技术洞察
DS
数据科学
数据科学与大数据分析学习平台
编程
编程人生
程序员成长与技术分享社区
云
云计算技术
云计算与分布式系统技术分享
链
区块链技术
区块链与加密货币技术研究
IoT
物联网技术
物联网与嵌入式系统开发
人工智能方向课程设计计划
经典论文入门推荐
点击查看PDF
点击查看PDF
点击查看PDF
经典论文入门推荐
难度通过 ★ 表示,对于更推荐的论文通过 ◆ 符号表示
📚 基础Backbone模型(通读)
AlexNet, VGG, ResNet, DenseNet
YOLO, R-CNN(难度★★)
📚 经典论文
1.
2.
3.
4.
Attention is All You Need (Transformer)
★★★★★❗❗❗
彻底革新了序列建模方式,引入多头注意力机制,是CV和NLP通用架构的根基,必须精读。
📄 transformer.pdf
2.1MB
5.
6.
7.
8.
9.
10.
11.
12.
13.
14.
15.
16.
每周入门4件事
• 在《国外来稿精译》中选择一节进行精读,学习如何分析论文动机、研究脉络等
• 阅读本领域内的3位AI领军学者/学生个人主页等了解领域前沿
阅读本领域内3位AI领军学者/学生个人主页等了解领域前沿,包括他们的研究兴趣、最新论文、研究组情况等,了解本领域的研究动态,同时可以学习他们的写作风格和表达方式。
• 选择一节VALSE Webinar中的前沿报告进行学习,了解领域动态
https://www.bilibili.com/video/BV1Rg4y1j7v5/?spm_id_from=333.999.0.0&vd_source=xxx
VALSE Webinar的个人主页VALSE Webinar的个人主页一站式视频理解。VALSE Webinar是一个致力于推动计算机视觉领域学术交流的平台,定期邀请领域内专家进行前沿报告。
• 从ArXiv选择一篇感兴趣的文章进行阅读,整理成PPT,随时汇报
https://arxiv.org/
arXiv.org e-Print archive
• 参与组内的同学在固定时间点开分享会学习进度汇报,拓宽彼此视野
研究生暑期启动计划 · 12周任务表(2025年)
第一组任务表
第一组同学将进行一次汇报,即分组数据和双数据,需要汇报在这两周内完成的内容情况
每一小组为3人
| 单数据 | 双数据 |
|---|---|
| 刘国医 | 邵磊 |
| 朱子豪 | 郑启明 |
| 刘庆安 | 金佳怡 |
第一周
- python基础+python环境配置(anaconda环境+Jupyter notebook)
- 线性代数:向量运算复习(快速过一下,通过代码熟悉向量和矩阵的操作)
- 线性回归:梯度下降+代价函数等涉及到的概念
- 逻辑回归:等涉及到的概念(如基本的概率内容)
任务:
- 通过代码学习相关内容(不只是理论,尤其是向量相关的操作,以及面向对象的方法)
- python实现线性回归+梯度下降具体算法
- 逻辑回归
1
- 1. 关于数据标准化的方式以及z-score为什么不能标准化?如果要等比例标准化会发生什么?
- 2. 解释在实现二分类、多分类、多标签分类时的原理是什么?一般会用到什么样的损失函数或 loss 分类?
- 3. 数据预处理时,为图像做归一化,不同一化会有什么问题?有什么归一化的方式?
- 4. Softmax分布的性质与其在深度学习中的作用是什么?
- 5. 为了稳定训练,避免梯度消失或爆炸,提出了 BatchNorm、LayerNorm、GroupNorm 等,他们分别是如何操作的,有什么优缺点,为什么要提出?
- 6. 数据预处理时是否要处理缺失值,如果要处理?如何做,是否可以用无监督的聚类等算法分析?
- 7. 在实际项目的过程中,使用不同的初始化方法有什么影响?
- 8. 直观理解 BatchNorm 的作用使优化更加稳定
- 9. 基于逻辑回归的二分类任务是否存在解释性?如果不用梯度下降,是否可以直接求得最终结果?
- 10. 规范化工作,在最后调参下阶段精度应该如何?
点击查看详情
第一周学习汇报
研究生暑期启动计划
汇报人:刘庆安
时间:2025年7月4日
第二周
- 多项式线性回归,多元逻辑回归,多标签识别,stacking学习
- k-nearest最近邻学习,随机森林学习,SVM
任务:
- 每天至少学习一种模型和sklearn实现
- 通过代码实现所有模型,并使用数据进行训练和测试
- 其他自行了解模型
第二周
多分类模型训练,多变量特征回归,多模态训练,self-supervised learning
k-means聚类学习,随机森林学习,SWM
任务:
每天至少学习一种模型及sklearn实现
- 1. 必做:通过代码实现所有模型,并使用数据集进行训练和测试
- 2. 选做:用自己的了解整理模型
汇报后问题汇总:
- 1. 多分类指标如何设计?混淆矩阵指标包括精确率、召回率和F1分别代表什么?macro/micro metrics适合什么场景?
- 2. 如果让数据分布合理,数据标准化归一化包括哪些方法?这些方法分别适用于什么分布数据?数据标准化方法有哪些?
- 3. Pooling的方式有哪些?GAM Pooling是如何实现的?多尺度的Pooling有什么创新的操作?
- 4. 最优化方法中重点讨论了不同的问题,梯度下降是其中最简单的一种,是否有使用二阶的优化器,他们是如何实现的,相比一阶有什么优势和什么缺点?
- 5. 极限学习机是什么?有什么应用场景?为什么输出层的权重可以直接用最小二乘法求解?
- 6. Multi-Class的Vision Transformer有什么改变?如果对特征图输出做softmax,将经过MLP和不经过MLP这两个东西分别会如何变换?
- 7. 图、树模型算法的典型代表是什么?如何构图、图上进行高效的搜索?Chain of Thought/Efficient Reasoning
- 8. SWM算法的version是什么?
- 9. 不同激活函数的优缺点和适用范围,请详细说明,现在在MLM中最常用的激活函数是什么?为什么要用它?
- 10. LabelSmoothCrossEntropy's different from Normal CrossEntropy?
第三周
学习基础神经网络结构,学习PyTorch基础,学习卷积神经网络CNN,学习循环神经网络RNN
了解关于调参和相关内容(RNN相关内容)
了解性能优化,batchnorm,了解数据增强与正则化技巧
2.多元线性回归实现
第3周任务代码:详见ppt.pdf
任务:
- 1. 必做:代码实现CNN和RNN的基础模型构建和训练测试(通过数据集用PyTorch)
- 2. 必做:代码实现数据增强并展示,展示增强前后的至少一种形式
损失函数
SmoothL1Loss
L1Loss
MSELoss
CrossEntropyLoss
NLLLoss
L1Loss
MSELoss
CrossEntropyLoss
NLLLoss
激活函数
Sigmoid
ReLU
LeakyReLU
Tanh
Softmax
LogSoftmax
ReLU
LeakyReLU
Tanh
Softmax
LogSoftmax
优化器
SGD
Adam
RMSprop
Adagrad
Adadelta
Adam
RMSprop
Adagrad
Adadelta
数据增强
RandomCrop
RandomHorizontalFlip
RandomVerticalFlip
ColorJitter
Normalize
ToTensor
RandomHorizontalFlip
RandomVerticalFlip
ColorJitter
Normalize
ToTensor
汇报问题整理
- 1. 大家在实现相关算法时不要简单套用API调用,最好能做一些底层的实现,这样对算法本质才会有更深刻的理解。请问,有哪些方法可以帮助我们更好地理解算法本质?
- 2. 请深入了解Tokenization是否必要?了解Tokenizer是什么? https://zhuanlan.zhihu.com/p/372272818 https://zhuanlan.zhihu.com/p/372272818
- 3. 卷积核的类型是什么?了解可变卷积核是什么?了解膨胀卷积是什么?大核卷积是什么?深度可分离卷积?对RNN的影响?
- 4. 什么是残差连接?DETR是什么?为什么现在主要检测都用它?
- 5. 什么是自注意力?什么是Memory Bank?
- 6. Multi-head Attention的作用是什么?每种注意力的优势是什么?哪一种注意力更好?为什么在大家都在用Transformer?
- 7. 为什么现在都在用Transformer?
- 8. 传统的方法实现的CNN/RNN为什么在处理大数据集下表现不如现在的Transformer?
- 9. 什么是一个完整的Backbone/Network?还有什么是可以用来提高中低层特征?它是如何做到的?
- 10. Dropout应用的对象可以是什么?神经元还是权重参数?原理是什么?
Pooling
Pooling的8种方法(或Global Pooling)如何实现的?
(1)Max Pooling(最大池化):选取每个局部区域中的最大值作为该区域的代表。
(2)Average Pooling(平均池化):计算每个每个局部区域中所有值的平均值作为该区域的代表。
(3)Sum Pooling(求和池化):对每个局部区域中的所有值求和作为该区域的代表。通常用在特征图的后处理上以。
(4)Global Max Pooling(全局最大池化):对整个特征图的每个通道进行取最大值,输出一个向量。
(5)Global Average Pooling(全局平均池化):对整个特征图的每个通道取平均值,输出一个向量。
(6)Stochastic Pooling(随机池化):根据每个元素的概率值随机选择,概率值根据元素值的大小计算。
(7)Spatial Pyramid Pooling(SPP,空间金字塔池化):使用不同大小的池化窗口来捕获多尺度信息,并将结果合并。
(8)Local Importance-based Pooling(局部重要性池化):基于输入特征的重要性自适应地调整池化区域。
大连理工大学
第三周组会汇报
—— 7.12-7.18 ——
第四周
学习内容:
- 学习ResNet, VGG, ResNeXt, DenseNet
- 学习LSTM, GRU
- 学习YOLO, R-CNN
任务:
- 1. 必做:代码实现ResNet训练与测试流程
- 2. 必做:YOLO在开源数据集上训练测试
- 3. 选做:YOLO原理报告与CNN可视化实现
汇报后问题汇总:
- 1. 绝对坐标预测和相对坐标预测,ROIPool是如何实现的?
- 2. Key cache是如何实现的?cache内部的内容是否可以删除?
- 3. 多头注意力为什么会有优势?具体怎么实现的?
- 4. 位置编码有什么作用?相对、绝对位置编码有什么区别和优点?
- 5. 数据增强时使用了哪些方法,为什么,有什么特点...
- 6. cross attention是如何发挥作用的?decoder是如何具体使用cross attention的?
- 7. Swin Transformer中的注意力机制在移动窗口后是如何计算的?和原来一样吗?是在小窗口计算还是拼接起来计算?具体是计算什么注意力?能够达到怎样的效果?
- 8. detr的bbox query是怎么来的?
- 9. detr的损失函数是如何在训练中应用的?在预测的时候,没有具体的标签了,是先使用匈牙利算法匹配的还是直接预测的?如果是直接预测的,根据是什么?
第四次组会-乔木.pptx
2023/8/8
👁️
第四次组会汇报-深度学习.pptx
2023/8/8
👁️
第五周
分工要求:
对于第一次的同学来说,每周需要完成两篇论文。对于简单和困难的论文来说,每个人先独立完成一篇论文,在结合上面的论文摘要进行学习和讨论论文。同时,鼓励简单和困难的同学一起学习,但是分开汇报。
请讨论的问题:
- 1. 这个论文解决了什么问题?
- 2. 要解决这个论文的创新点在哪里?
- 3. 是否有哪些知识不了解需要学习?(例如一些论文会依赖前面部分论文,需要自行查找补充的知识)
- 4. 在这个论文中你学到了哪些内容?
| 论文 | 汇报人(简单) | 汇报人(困难) |
|---|---|---|
| Attention Is All You Need (Transformer) | 张子豪 | 张明阳 |
| Swin Transformer | 刘思远 | 李浩然 |
| MoCo | 陈思雨 | 王梦琪 |
注:transformer论文十分重要,没有选择这个的同学也要看一下这篇,结合上面这四篇学习进一步增强自己的理解。同时选择了这篇论文的同学也要认真学习并做好汇报,汇报内容要包含论文的重点部分。
第六周
任务:
- 必做:PPT展示本周学习内容
- 必做:组内自行安排讨论,统一汇报本周完成内容。每个人汇报自己在该篇论文中完成了哪些内容。
- 选做:展示自己读代码or复现内容
| 论文 | 报告人(单人) | 报告人(双人) |
|---|---|---|
| VIT | 刘凯航 | 邵峰 |
| BYOL | 朱子锋 | 郑明 |
| MAE | 刘庆安 | 金世怡 |
第七周
任务:
- 必做:PPT展示本周学习内容
- 必做:组内自行安排讨论,统一汇报本周完成内容。每个人汇报自己在该篇论文中完成了哪些内容。
- 选做:展示自己读代码or复现内容
| 论文 | 报告人(单人) | 报告人(双人) |
|---|---|---|
| Swin Transformer | 刘庆安 | 金世怡 |
| DeiT | 朱子锋 | 邵峰 |
| DETR | 刘凯航 | 郑明 |
第八周
任务:
- 必做:PPT展示本周学习内容
- 必做:组内自行安排讨论,统一汇报本周完成内容。每个人汇报自己在该篇论文中完成了哪些内容。
- 选做:展示自己读代码or复现内容
| 论文 | 报告人(单人) | 报告人(双人) |
|---|---|---|
| GPT | 刘庆安 | 金世怡 |
| BERT | 朱子锋 | 邵峰 |
| LoRA | 刘凯航 | 郑明 |
第九周
任务:
- 必做:PPT展示本周学习内容
- 必做:组内自行安排讨论,统一汇报本周完成内容。每个人汇报自己在该篇论文中完成了哪些内容。
- 选做:展示自己读代码or复现内容
自本阶段起,每组没有具体任务,需要自行寻找在阅读论文过程中,感兴趣的方向。做更深入的了解调研,以及代码阅读及复现工作。需要PPT和汇报(或者其他展示方式),两周一次进行汇报,讲述这两周内容的完成情况。
第十二周
所有人都需要在最近进行一次汇报,并对整个课程内容做最终小结。
第二组任务表
第一周
线性代数:向量运算+python基础+python环境安装(anaconda环境+jupyter notebook笔记)
了解什么是机器学习,深度学习,监督学习,非监督学习
任务:
- 必做:PPT展示展示学习内容
- 必做:jupyter展示展示代码练习情况(向量量运算和面向对象编程)
第二周
线性回归+梯度下降+什么是模型 等涉及到的概念
逻辑回归归 同步涉及到的概念
运用:会用代码实现梯度下降 完整的基础理论内容
任务:
- 必做:PPT展示本周学习内容
- 必做:jupyter中用代码实现一元线性回归,使用梯度下降法,使用房价价格预测数据集(使用pandas的方式完成,不要使用调库的方式)
- 选做:jupyter中用代码实现逻辑回归,使用梯度下降法,使用高低斯塞花数据集(自行进行数据清洗)
第三周
多元元线性回归,多元逻辑回归,多层感知机,sklearn学习
思考:多分类和多标签分类分别别通过什么方式实现?
任务:
- 必做:PPT展示本周学习内容
- 必做:jupyter展示,通过sklearn实现多元元逻辑回归
- 选做:jupyter展示,实现多层感知机
第四周
k-means聚类算法,随机森林学习,SVM
任务:
- 必做:PPT展示本周学习内容
- 必做:jupyter展示,k-means聚类实现聚类
- 选做:jupyter展示,通过随机森林进行预测
- 选做:jupyter展示,SVM实现分类预测
第五周
- 了解神经网络入门,了解神经网络的概念和运算方式(包括激活函数等内容),pytorch基础
- 了解基础卷积神经网络CNN,基础循环神经网络RNN
任务:
- 必做:PPT展示本周学习内容
- 必做:jupyter展示,pytorch实现基础的全连接神经网络,并使用选过的数据集完成预测
- 必做:jupyter展示,pytorch实现基础的CNN,完成手写数字分类项目训练和预测
- 选做:jupyter展示,pytorch实现基础的RNN,完成文本的情感分析(附带CNN代码),项目训练和预测
第六周
- 了解关于网络深入相关内容(RNN相关内容)
- 了解标准化,batchnorm层,了解数据增强与正则化技巧
- 学习AlexNet, VGG, ResNet, DenseNet
- 学习LSTM, GRU
任务:
- 必做:PPT展示本周学习内容
- 必做:jupyter展示,展示实现上面和下面的模型各一种(可以使用pytorch自带的),通过数据集进行训练和测试
- 必做:jupyter展示,对数据进行增强,展示数据增强前后的状态
- 选做:展示多个模型
第七周
分论文:
一个论文需要分组来完成,可以,可以直接填写到表格名,该论文的基础要求:
- 要说这个论文的核心创新点是什么?
- 要解决这个论文什么什么问题?
- 是否需要前置知识知识?需要哪些学习?(例如一些文章会提前前面部分论文,需要自行自行行查找补充相关知识)
- 在这个论文中你学到了哪些内容?
- 你在本次分担论文中负责了哪些内容?
| 论文 | 人数 | 负责人 |
|---|---|---|
| YOLO | 2 | 冯明辉 王泽瑞 |
| R-CNN | 2 | 徐兆楠 王泽延 |
| SimCLR | 3 | 张培基 张孟铭 |
任务:
- 必做:PPT展示本周周学习内容
- 必做:组内自行安排讨论,统一一汇报本周周完成内容。每个人汇报自己在该篇论文中完成了哪些内容。
- 选做:展示自己读代码or复现内容
第八周
分论文
| 论文 | 人数 | 报名人 |
|---|---|---|
| Attention is All You Need (Transformer) | 3 | 金世怡 冯明辉 徐兆楠 王泽瑞 |
| MoCo | 2 | 张培基 张孟铭 |
| BYOL | 2 | 徐兆楠 张孟铭 |
注:transformer论文十分重要,没有选择这个组的同学也要有一定了解。班会上课通过同学分享进一步增强自己的理解情况。同时选择了这篇论文的同学必须认真学习并做详细汇报,汇报内容完整优秀者会适当加分。
任务:
- 必做:PPT展示本周学习内容
- 必做:组内自行安排讨论,统一汇报本周完成内容。每个人汇报自己在该篇论文中完成了哪些内容。
- 选做:展示自己读代码or复现内容
第九周
分论文
| 论文 | 人数 | 报名人 |
|---|---|---|
| ViT | 3 | 冯明辉 徐兆楠 |
| DeiT | 2 | 张培基 |
| MAE | 2 | 金世怡 王泽瑞 |
任务:
- 必做:PPTT展示本周学习内容
- 必做:组内自行安排讨论,统一一汇报本周完成内容。每个人汇报自己在该篇论文中完成了哪些内容。
- 选做:展示自己读代码or复现内容
第十周
分组论文
| 论文 | 人数 | 报名人 |
|---|---|---|
| Swin Transformer | 3 | 王泽瑞 张培基 徐兆楠 |
| DETR | 2 | 朱子锋 郑明 |
| EfficientViT | 2 | 刘庆安 金世怡 |
任务:
- 必做:PPT展示本周学习内容
- 必做:组内自行安排讨论,统一汇报本周完成内容。每个人汇报自己在该篇论文中完成了哪些内容。
- 选做:展示自己读代码or复现内容
第十一周
分组论文
| 论文 | 人数 | 报名人 |
|---|---|---|
| GPT | 3 | 余洪峰 张培基 |
| CLIP | 2 | 冯春雨 王泽瑞 |
任务:
- 必做:PPT展示本周学习内容
- 必做:组内自行安排讨论,统一汇报本周完成内容。每个人汇报自己在该篇论文中完成了哪些内容。
- 选做:展示自己读代码or复现内容
第十二周
分组论文
| 论文 | 人数 | 报名人 |
|---|---|---|
| BERT | 3 | 王泽瑞 张培基 |
| LLM-Adapter | 2 | 余洪峰 |
| LoRA | 2 | 冯春雨 |
任务:
- 必做:PPT展示本周学习内容
- 必做:组内自行安排讨论,统一汇报本周完成内容。每个人汇报自己在该篇论文中完成了哪些内容。
- 选做:展示自己读代码or复现内容
- 选做:课程小结
论文精读列表
深度学习代表性论文清单
卷积神经网络 (CNN)
| Paper | Year | 简介 |
|---|---|---|
| AlexNet | 2012 | 打破 ImageNet 基准,首次展示深层 CNN 在大规模图像分类中的突破性性能 |
| VGGNet | 2014 | 使用3x3卷积核,证明深度网络能显著提升性能 |
| GoogLeNet (Inception) | 2014 | 提出 Inception 模块,通过多尺度卷积提升效率,参数更少精度更高 |
| ResNet | 2015 | 引入残残差连接,解决深层网络训练问题,使网络能轻松轻松训练到数百层 |
| DenseNet | 2017 | 提出密集连接结构,提高特征复用率和梯度传播效果 |
Transformer 与注意力机制
| Paper | Year | 简介 |
|---|---|---|
| Attention is All You Need | 2017 | 提出Transformer架构,用注意力注意力机制替代RNN、CNN,在NLP任务上取得突破性成果 |
| BERT | 2018 | 使用双向Transformer预训练语言模型,显著提升NLP下游任务性能 |
| Vision Transformer (ViT) | 2020 | 将Transformer应用于图像分类,展现大规模数据下的强大性能 |
| Swin Transformer | 2021 | 引入分层结构与滑动窗口注意力,使Transformer可扩展至多种视觉任务 |
生成模型
| Paper | Year | 简介 |
|---|---|---|
| GAN | 2014 | 提出生成对抗网络框架,通过生成器和判别器的对抗训练实现真实数据分布的学习 |
| pix2pix | 2016 | 基于条件GAN的图像到图像翻译,可用于语义分割图转真实图像等任务 |
| CycleGAN | 2017 | 无需配对数据的图像域转换,利用循环一致性损失实现 |
| StyleGAN | 2018 | 引入风格控制机制,能够生成高质量、高分辨率的人脸图像 |
| StyleGAN2 | 2019 | 改进StyleGAN,进一步提升生成图像质量,解决训练不稳定问题 |
| Diffusion Models | 2020 | 基于随机过程的生成模型,通过逐步去噪生成高质量图像 |
| DALL·E | 2021 | 大型文本到图像生成模型,能够根据文本描述创建独特图像 |
| Stable Diffusion | 2022 | 开源的AI图像生成模型,推动AIGC技术普及 |
目标检测
| Paper | Year | 简介 |
|---|---|---|
| OverFeat | 2013 | 早期将深度学习应用于目标检测的方法,将CNN用于分类、定位和检测 |
| R-CNN | 2014 | 结合CNN与候选区域方法,大幅提升目标检测性能 |
| Fast R-CNN | 2015 | 共享卷积特征,引入ROI池化层,提高检测速度 |
| Faster R-CNN | 2016 | 提出RPN网络,实现端到端的目标检测框架 |
| YOLO | 2016 | 将目标检测视为回归问题,实现实时检测 |
| SSD | 2016 | 多尺度特征图检测,兼顾速度与精度 |
| RetinaNet | 2017 | 提出Focal Loss,有效解决类别不平衡问题 |
| YOLOv3 | 2018 | 多尺度预测,结合残差网络,提升检测精度 |
| YOLOv4 | 2020 | 结合多种优化技巧,在速度和精度上都有显著提升 |
| YOLOv5 | 2020 | 工程化优化,模型更小,训练和推理速度更快 |
| YOLOv7 | 2022 | 改进结构与训练策略,在轻量化与精度间取得得平衡 |
| YOLOv8 | 2023 | 支持检测、分割、姿态估计等多任务,最新YOLO框架 |
| DETR | 2020 | 首次将Transformer引入检测,实现端到端集合预测 |
| Deformable DETR | 2020 | 提出可变形注意力,解决DETR收敛慢的问题 |
对比学习
| Paper | Year | 简介 |
|---|---|---|
| SimCLR | 2020 | 大批量对比学习,通过数据增强和 InfoNCE 损失学习表征 |
| MoCo | 2020 | 提出动量对比学习框架,通过队列和动量编码器实现高效训练 |
| BYOL | 2020 | 摒弃负样本,通过两个网络互相预测进行自监督学习 |
| SwAV | 2020 | 将在线聚类与对比学习结合,提升效率和表征质量 |
| SimSiam | 2021 | 极简框架,无需负样本或大批量,即可有效学习表征 |
视频理解
| Paper | Year | 简介 |
|---|---|---|
| C3D | 2014 | 提出3D卷积,利用时空特征处理视频分类和动作识别 |
| TSN | 2016 | 提出时间分段采样策略,在长视频中进行高效动作识别 |
| I3D | 2017 | 将2D卷积扩展为3D卷积,并利用ImageNet预训练提升性能 |
| SlowFast | 2019 | 双路径网络架构,同时处理慢速和快速动态变化 |
| TimeSformer | 2021 | 首个全Transformer视频,利用分块注意力捕捉时序信息 |
多模态大模型
| Paper | Year | 简介 |
|---|---|---|
| CLIP | 2021 | OpenAI提出的对比学习模型,连接文本和图像,实现跨模态检索任务 |
| ALIGN | 2021 | Google提出大规模对比学习模型,使用噪声网络数据进行训练,性能优异 |
| Flava | 2021 | Facebook提出的多模态基础模型,支持多种模态任务 |
| Flamingo | 2022 | DeepMind提出的多模态大模型,通过少样本学习实现跨模态理解 |
| BLIP | 2022 | 提出视觉语言预训练模型,实现图像描述和视觉问答等任务 |
| BLIP-2 | 2023 | 引入轻量级适配器连接预训练语言模型,实现更强的多模态理解能力 |
| Kosmos-1 | 2023 | 微软提出多模态模型,支持语言、视觉、语音等多模态理解 |
| GPT-4V | 2023 | OpenAI推出的多模态大模型,支持图像理解与分析 |
轻量化与高效网络
| Paper | Year | 简介 |
|---|---|---|
| SqueezeNet | 2016 | 提出Fire模块,通过1x1卷积减少参数量,实现轻量级CNN |
| MobileNetV1 | 2017 | 使用深度可分离卷积,大幅降低计算量,适用于移动设备 |
| ShuffleNet | 2017 | 通过通道混洗和组卷积实现高效网络结构 |
| MobileNetV2 | 2018 | 提出倒残差结构与线性瓶颈,提升性能和稳定性 |
| MobileNetV3 | 2019 | 结合NAS与NetAdapt,进一步优化移动网络性能 |
| EfficientNet | 2019 | 提出复合缩放方法,实现精度与效率的最佳平衡 |
| GhostNet | 2020 | 提出Ghost模块,通过低成本操作生成更多特征图,降低计算复杂度 |
多模态融合下游任务
(检测、分割、追踪、图像理解)
| 论文 | 链接 | 简介 |
|---|---|---|
| X-VLM | Paper | 将视觉-语言预训练扩展到理解和生成任务,支持图像描述、视觉问答等 |
| MAE-DETR | Paper | 基于Transformer的目标检测器,支持端到端的目标检测 |
| LAVIS | Paper | 统一多模态理解与生成框架,支持图像描述、视觉问答等任务 |
| ViTDet | Paper | 基于Vision Transformer的目标检测框架,用于各种视觉理解任务 |
| CvT (Convolutional Vision Transformer) | Paper | 将卷积与Transformer结合,用于图像分类和其他视觉识别任务 |
| TrackFormer | Paper | 基于Transformer的多目标跟踪方法,支持端到端的目标检测和跟踪 |
| MOTR | Paper | 将Transformer应用于多目标跟踪,实现端到端的跟踪和检测 |
| LISA | Paper | 基于Transformer的实时语义分割框架,使用多尺度特征融合提高分割精度 |
| GLaMM | Paper | 像素级接地大型多模态模型,能生成嵌入目标分割掩码的自然语言响应,接受文本和图像输入 |
图神经网络
| 论文 | 链接 | 简介 |
|---|---|---|
| GCN | Paper | 图卷积网络,基础图结构学习方法 |
| GraphSAGE | Paper | 可扩展图神经网络,支持大规模图数据 |
| GAT | Paper | 图注意力网络,通过注意力机制聚合邻居信息 |
| Graphormer | Paper | Transformer架构在图结构数据上的应用,适合分子和知识图谱 |
| GraphCL | Paper | 对比学习在图结构上的应用,提高无监督图表示能力 |
大语言模型(LLM)
| Paper | Year | 简介 |
|---|---|---|
| GPT | 2018 | OpenAI发布的基于Transformer的生成式预训练模型,开启了现代LLM时代 |
| BERT | 2018 | Google提出的双向Transformer预训练模型,在多种NLP任务上取得突破 |
| GPT-2 | 2019 | GPT的改进版,拥有15亿参数,展示了更强的语言生成能力 |
| T5 | 2020 | Google提出的统一框架,将所有NLP任务转换为文本到文本的生成任务 |
| GPT-3 | 2020 | 拥有1750亿参数的大型语言模型,展示了少样本和零样本学习能力 |
| LLaMA | 2023 | Meta发布的开源大型语言模型,参数规模从7B到65B不等 |
| PaLM | 2022 | Google的540B参数语言模型,在多语言和推理任务上表现出色 |
| GPT-4 | 2023 | OpenAI发布的多模态大型语言模型,支持文本和图像输入 |
| BLOOM | 2022 | BigScience项目开发的开源100B参数的开源多语言大型语言模型 |
| ChatGPT | 2022 | 基于GPT-3.5的对话模型,通过RLHF提升交互体验 |
| Mistral | 2023 | 开源高效LLM,采用分组查询注意力(GQA)与滑动窗口注意力 |
| Mixtral | 2024 | MoE架构高效大模型,激活部分专家以降低推理成本 |
| 阶段 | 工作任务 | 具体内容 | 输出成果 | 负责人 | 截止时间 | 状态 | 备注 |
|---|---|---|---|---|---|---|---|
| 阶段1:基础模型调研与选择 | 建立基础模型库 | 调研主流基础模型,包括CLIP、ALBEF、BLIP-2等,分析其特点和适用场景 | 基础模型调研文档,包含模型特点、性能对比和适用场景分析 | 负责人A | 第1周周一 | 未开始 | 根据项目需求,选择最适合的基础模型 |
| 收集基础模型的开源代码和预训练权重,搭建模型评估框架 | 基础模型代码库,包含模型实现和评估代码 | 同学B | 第1周周三 | 未开始 | 重点关注模型的预训练数据集和性能指标 | ||
| 阶段2:数据集构建与预处理 | 建立数据集构建标准 | 设计数据集构建流程,包括数据收集、清洗、标注等环节 | 数据集构建标准文档,包含详细的流程说明和质量控制标准 | 负责人A | 第2周周一 | 未开始 | 参考相关文献,制定科学合理的数据集构建方案 |
| 收集多模态数据,包括图像、文本等,并进行数据清洗和预处理 | 原始数据集和预处理后的数据集,包含数据统计信息 | 同学B | 第2周周五 | 未开始 | 确保数据集的多样性和质量,为后续模型训练提供良好的数据基础 | ||
| 阶段3:学习算法设计(核心) | 设计学习算法框架 | 研究对比学习、度量学习等方法,设计适合多模态数据的学习算法框架 | 学习算法框架设计文档,包含算法原理、流程和伪代码 | 负责人A | 第3周周一 | 未开始 | 结合项目需求,设计创新的学习算法框架 |
| 实现学习算法,并进行初步实验验证 | 学习算法代码实现,包含初步实验结果和分析 | 同学B | 第3周周三 | 未开始 | 重点关注算法的收敛性和性能表现 | ||
| 设计任务评估指标,构建评估体系 | 任务评估指标设计文档,包含指标定义和计算方法 | 同学A | 第3周周五 | 未开始 | 参考相关文献,设计全面的评估指标体系 | ||
| 阶段4:代码实现与系统集成 | Git实现与系统集成 | Git实现所有模块,并进行系统集成和测试 | 完整的代码实现,包含系统集成文档和测试报告 | 同学B | 第4周周二 | 未开始 | 确保代码的可读性和可维护性,为后续项目交付做好准备 |
| 阶段5:学习进度追踪 | 建立学习进度追踪系统 | 设计学习进度追踪方案,包括学习目标设定、进度记录和评估机制 | 学习进度追踪方案设计文档,包含详细的流程说明和评估标准 | 同学A | 第4周周三 | 未开始 | 可根据项目进展动态调整学习目标 |
| 实现学习进度追踪工具,包括数据收集、分析和可视化功能 | 学习进度追踪工具,包含数据可视化界面和分析报告 | 负责人A | 第4周周五 | 未开始 | 结合项目实际需求,设计实用的学习进度追踪工具 | ||
| 阶段6:周报与进度汇报 | 建立周报制度和进度汇报机制 | 设计周报模板,包括工作内容总结、遇到的问题和下周计划 | 周报模板和填写说明文档 | 负责人A | 第4周周四 | 未开始 | 结合项目特点,设计简洁实用的周报模板 |
| 建立进度汇报机制,包括定期会议和进度展示方式 | 进度汇报机制设计文档,包含会议安排和展示方式说明 | 同学A | 第4周周五 | 未开始 | 确保信息及时传递,便于项目管理和决策 | ||
| 实现周报自动生成工具,提高工作效率 | 周报自动生成工具,包含数据收集和报告生成功能 | 同学B | 第4周周五 | 未开始 | 每周进行一次进度汇报,及时发现和解决问题 |
留下你的想法吧
欢迎在下方评论区发表意见、提问或分享灵感 💡。登录 GitHub 后即可留言。